Agent Optimizasyonu: Production’da Farkı Yaratan Şey Prompt Değil, Sistem Tasarımı

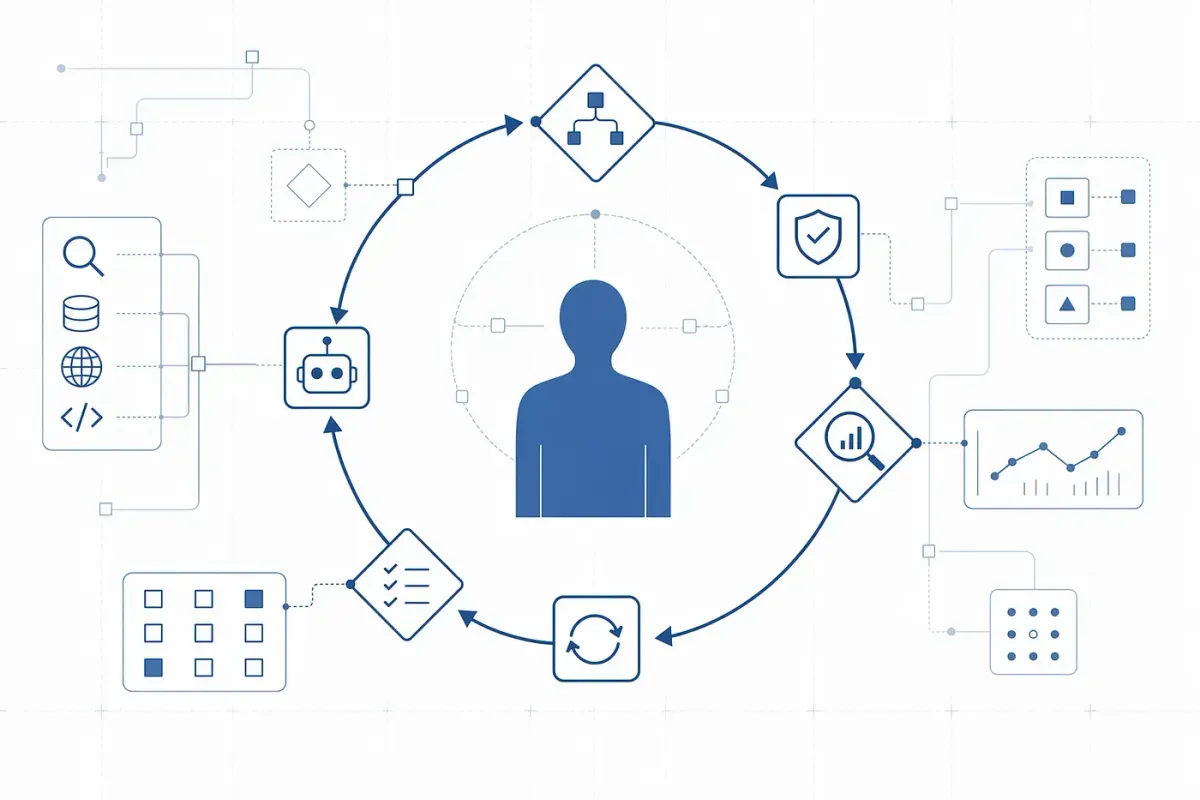
LLM agent sistemleri büyüdükçe aynı problem tekrar tekrar karşımıza çıkıyor: ekipler önce modeli, sonra prompt’u, sonra da context window’u büyütüyor; ama sistem yine pahalı, yavaş ve kırılgan kalıyor. Çünkü production’da asıl darboğaz çoğu zaman model kalitesi değil; yanlış context taşıma, kötü tool arayüzleri, zayıf ölçümleme ve gereksiz karmaşıklıkoluyor.
Son dönemde Anthropic, OpenAI, Google, Microsoft, LangChain ve Cognition çizgisinde çıkan yazılar birlikte okunduğunda ortak bir resim beliriyor: iyi agent sistemleri, daha büyük model kullandıkları için değil; aynı işi daha az token, daha az gereksiz tool call ve daha yüksek tutarlılıklayaptıkları için kazanıyor (Anthropic — Building Effective Agents; Microsoft Foundry — Agent Evaluators).
Bu yüzden LLM agent optimizasyonunu “prompt tweak” meselesi gibi ele almak artık yetersiz. Asıl mesele, sistemin nasıl kurgulandığı.
1. Önce basit akış kur, sonra karmaşıklığı kanıtla
Agent sistemlerinde en yaygın hata, daha baştan planner, verifier, reflection, guardrail katmanları, hafıza bileşenleri ve multi-agent mimariler eklemek. Oysa sahadaki güçlü pratik bunun tersini söylüyor: önce en basit çalışan akışı kur, sonra ancak ölçülebilir fayda getiriyorsa karmaşıklık ekle(Anthropic — Building Effective Agents).
Bu yaklaşımın önemli bir avantajı var: sistem hem daha hızlı çıkar hem de daha kolay gözlemlenir. Sorun çıktığında nerede bozulduğunu anlamak mümkündür. Fazladan orchestration katmanları ise çoğu zaman kalite artışından önce yeni hata yüzeyleri üretir.
Kısacası, agent mimarisinde karmaşıklık varsayılan değil; ispatlanması gereken bir yatırımdır.
2. Prompt engineering’den context engineering’e geçiyoruz
Bugün agent reliability’yi belirleyen temel konu, tek başına system prompt’un kalitesi değil. Asıl farkı yaratan şey, modele hangi bilginin, ne zaman, hangi sırayla ve ne yoğunlukta verildiği. Anthropic’in son dönemde özellikle vurguladığı konu da bu: prompt engineering’den çok, context engineering düşünmek gerekiyor (Anthropic — Effective context engineering for AI agents; LangChain — Context Engineering for Agents).
Uzun ömürlü agent’larda bozulma çoğu zaman şuradan geliyor:
- stale state
- gereksiz transcript birikimi
- büyük ama düşük sinyalli tool çıktıları
- aynı bağlamın her adımda yeniden taşınması
Büyük context window bu sorunu otomatik çözmüyor. Hatta yanlış bilgiyi daha pahalı taşımaya da yarayabiliyor. Bu yüzden iyi ekipler context’i büyütmeye çalışmadan önce context’i temizliyor, ayırıyor, özetliyor ve gerçekten gerekli olanla sınırlıyor.
3. Uzun prompt çoğu zaman çözüm değil, tasarım kokusudur
Agent ekiplerinin sık düştüğü başka bir tuzak da her problemi system prompt’a gömmek. İş kuralları, tool kullanma mantığı, edge case yönetimi, güvenlik kuralları, ton ayarı, exception handling… Hepsi tek bir dev prompt’a yığılıyor.
Bu yaklaşım kısa vadede kontrol hissi verse de uzun vadede sistemi kırılganlaştırıyor. Çünkü aşırı uzun prompt’lar bakım maliyetini artırıyor, çelişkili talimat riskini büyütüyor ve model davranışını daha az öngörülebilir hale getiriyor. Anthropic’in engineering yazıları da tam olarak buna karşı daha minimal ama yeterli bir yaklaşım öneriyor (Anthropic — Effective context engineering for AI agents).
Buradaki pratik kural şu: bir prompt uzadıkça önce şunu sormak gerekiyor: Gerçekten prompt mu büyümeli, yoksa tool tasarımı, state yapısı veya context akışı mı düzeltilmeli?
4. Tool design, prompt’tan daha büyük kaldıraç yaratabiliyor
Production agent’larda kaliteyi düşüren en kritik alanlardan biri kötü tool tasarımı. Yanlış isimlendirilmiş araçlar, belirsiz parametreler, çok geniş kapsamlı endpoint’ler, gereksiz büyük JSON çıktıları ve zayıf açıklamalar agent’ın hata oranını hızla artırıyor.
Bu yüzden tool design artık yardımcı bir detay değil, birinci sınıf optimizasyon alanı. Anthropic’in tool yazımı üzerine önerileri ve LangChain’in aktardığı saha notları aynı noktayı güçlendiriyor: bazı ekipler prompt’u optimize etmekten çok, araç arayüzlerini optimize ederek daha büyük kalite artışı görüyor (Anthropic — Writing effective tools for agents; LangChain — Agent Evaluation Readiness Checklist).
İyi tool tasarımının birkaç temel etkisi var:
- yanlış tool seçimini azaltır
- yanlış argüman üretimini düşürür
- context şişmesini kontrol eder
- retry ihtiyacını azaltır
- latency ve maliyeti birlikte düşürür
Özetle: modele daha iyi düşünmeyi öğretmek kadar, sisteme daha iyi araçlar vermek de önemlidir.
5. Tool output’u değil, karar vermeyi besleyen bilgiyi taşı
Agent sistemlerinin maliyetini ve gecikmesini artıran büyük nedenlerden biri, araçlardan gelen ham çıktının olduğu gibi modele geri verilmesi. Özellikle log, HTML, büyük JSON, uzun arama sonuçları veya büyük dosya içerikleri bu konuda sıkıntı yaratıyor.
Daha iyi yaklaşım şu: ham veriyi değil, karar vermeyi besleyen sıkıştırılmış veriyi taşı. Gerekirse büyük çıktıyı dışarıda tut, modele sadece özet + preview + pointer ver. Anthropic ve LangChain tarafındaki öneriler de bu yönde (Anthropic — Writing effective tools for agents; LangChain — Context Engineering for Agents).
Bu yaklaşım yalnızca token maliyetini azaltmıyor; aynı zamanda modelin odağını da artırıyor. Çünkü model artık veri çöplüğü içinde sinyal aramak zorunda kalmıyor.
6. Caching artık küçük optimizasyon değil, mimari karar
LLM agent’larda tekrar eden sabit bağlamlar çok yaygın: system prompt, policy blokları, tool şemaları, kurum bilgileri, referans dökümanlar, örnekler… Bunların her istekte yeniden modele taşınması gereksiz maliyet ve latency üretiyor.
Bu noktada caching yaklaşımı kritik hale geliyor. OpenAI tarafındaki prompt caching ve Google tarafındaki context caching yaklaşımı, tekrar eden prefix’lerin ve büyük sabit bağlamların yeniden kullanılmasının ciddi avantaj yarattığını gösteriyor (OpenAI — Prompt Caching docs; OpenAI Cookbook — Prompt Caching 201; Google Cloud — Vertex AI context caching).
Buradaki temel prensip basit: sabit olanı stabil tut, dinamik olanı sona koy. Doğru cache boundary seçimi, agent sistemlerinde birim ekonomiyi ciddi biçimde etkileyebiliyor.
7. Her işi en güçlü modele vermek iyi tasarım değil
Agent optimizasyonunda bir diğer kritik alan da model routing. Her adımı en pahalı ve en güçlü modele vermek çoğu zaman iyi mimari değildir. Çünkü sınıflandırma, extraction, planlama, yürütme ve doğrulama aynı zeka seviyesini gerektirmez.
Pratikte daha iyi çalışan yaklaşım genelde sade bir katmanlama oluyor: cheap / mid / strong. Düşük riskli ve yüksek hacimli işleri daha ucuz modellerle çözmek, yalnızca gerçekten zor veya riskli adımlarda güçlü modele çıkmak maliyet ve latency açısından çok daha sağlıklı bir denge sunuyor.
Yani model seçimi yalnızca kalite kararı değil; doğrudan bir sistem ekonomisi kararı.
8. Eval olmadan optimizasyon, sezgiyi ölçmektir
Agent sistemleri için “çalışıyor gibi görünüyor” yeterli bir metrik değil. Çünkü production başarısı sadece tek seferlik doğru cevapla ölçülmüyor. Aynı sistem benzer doğruluğu çok farklı maliyetlerle üretebilir; tek seferde başarılı görünen akış tekrarlandığında tutarsız hale gelebilir.
Bu yüzden offline eval, online gözlemleme ve trace düzeyinde observability birlikte kurulmalı. Microsoft Foundry, LangChain ve yeni akademik çerçeveler aynı noktaya işaret ediyor: cost, latency, reliability ve consistency birlikte ölçülmeli (Microsoft Foundry — Agent Evaluators; LangChain — Agent Evaluation Readiness Checklist; CLEAR).
Bu çok önemli bir ayrım. Çünkü “agent bu işi yapabiliyor mu?” sorusu tek başına yetersiz. Doğru soru şu: bu işi hangi maliyet, hangi gecikme ve hangi güvenilirlik düzeyiyle yapabiliyor?
9. Multi-agent güçlüdür ama varsayılan cevap değildir
Son dönemde multi-agent mimariler büyük ilgi görüyor. Bunun nedeni anlaşılır: paralel araştırma, farklı hipotezlerin ayrı ayrı denenmesi ve alt görevlerin ayrıştırılması bazı senaryolarda gerçekten güçlü sonuçlar veriyor.
Ama burada kritik nokta şu: multi-agent sistemler ciddi bir coordination overhead ve token maliyeti getiriyor. Anthropic’in multi-agent research system deneyimi bu maliyetin bazı durumlarda tek bir chat akışına göre çok daha yüksek olabildiğini gösteriyor (Anthropic — How we built our multi-agent research system). Cognition da benzer şekilde manager-agent yaklaşımının bağlam eksikliği ve aşırı yönlendirme riski taşıdığını vurguluyor (Cognition — Multi-Agents: What’s Actually Working).
Bu yüzden multi-agent bir “default architecture” değil. Ancak görev gerçekten yüksek değerliyse, alt parçalara ayrışıyorsa ve paralelleştirme anlamlı fayda getiriyorsa mantıklı hale geliyor.
Sonuç
LLM agent optimizasyonunda asıl sıçrama, daha büyük model veya daha uzun prompt ile gelmiyor. Asıl farkı yaratan şey; doğru context tasarımı, iyi tool arayüzleri, akıllı routing, caching disiplini ve çok boyutlu eval yaklaşımı.
Kısacası production’da iyi agent sistemleri, daha fazla şey yapan sistemler değil; aynı işi daha temiz, daha ucuz, daha hızlı ve daha tutarlı yapan sistemlerdir.
Ve belki bugün için en doğru kısa özet şu:
Prompt’u büyütmeden önce sistemi sadeleştir. Modeli büyütmeden önce context’i düzelt. Multi-agent kurmadan önce bunun gerçekten gerekli olduğunu kanıtla.