Tool-Heavy Agent’lar ve Context Engineering: Bağlam Taşmasını Yönetmek (Pratik Rehber)

Bu yazı, “tool-heavy” (araç çağrısı yoğun) agent’larda en kritik problemlerden biri olan context (bağlam) yönetiminipratik örneklerle anlatır. Özellikle arama, kod tabanı analizi, ERP/CRM iş akışları gibi ardışık tool çağrıları gerektiren senaryolarda, bağlam taşması ve kalite düşüşünü nasıl yöneteceğimize odaklanır.
Problem: Tool-heavy agent’lar neden “context engineering” ister?
Klasik bir agent akışında kullanıcı bir soru sorar ve agent iki şekilde yanıt üretir:
- Model içi bilgiyle: Sistem prompt’u + geçmiş konuşma + kısa hafıza ile doğrudan yanıt.
- Tool çağırarak: Arama, veri tabanı, dosya sistemi, CRM, ticket sistemi, codebase taraması gibi dış kaynaklardan veri çekip sentez.
Tool-heavy senaryolarda ikinci yol baskın hale gelir. Çünkü cevap tek bir tool çağrısından değil, çoğu zaman bir dizi iteratif çağrıdan oluşur:
- Arama → sonuçlar yetersiz → aramayı refine et → tekrar dene
- Repo taraması → benzer implementasyonları bul → bağımlılıkları oku → değişikliği uygula
- ERP/CRM → 1000 satır insert/update → her satırda doğrulama/lookup → tekrar
Bu noktada ana risk şudur:
Tool çıktıları büyüdükçe bağlam uzar, bağlam uzadıkça modelin tek seferde işleyebildiği token limitine yaklaşırsın. Limit aşımı “hata” olarak gelebilir veya bazı sistemler otomatik kırpma yapar; ikisi de kaliteyi düşürür.
Bağlam taşması olduğunda pratikte ne bozulur?
Bağlam taşması sadece “hata aldım” demek değil; daha sinsi bir problem:
- Kritik bir tool çıktısı geçmişte kaldığı için model onu artık “göremez”.
- Model, daha önce yaptığı bir adımı unutur → aynı tool’u tekrar çağırır → maliyet artar.
- Zincir görevlerde küçük bir unutma → yanlış varsayım → yanlış karar → downstream bozulma.
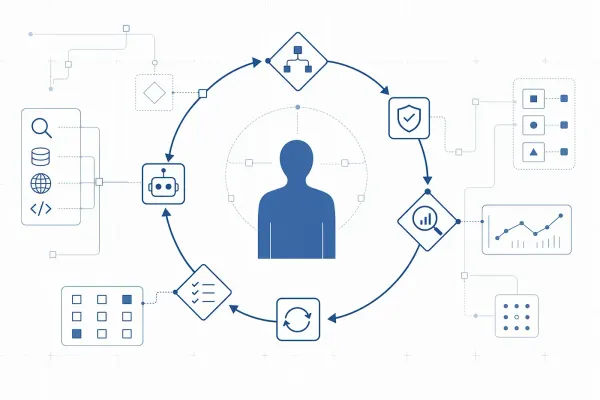
Özellikle “ara, bul, doğrula, uygula, tekrar doğrula” gibi döngülerde bu etkiler katlanır.
Gerçek hayat örnekleri: Tool-heavy agent profilleri
1) Kod yazan / codebase içinde gezen agent
İstenen: “Yeni bir feature ekle.”
Agent’ın pratikte yapacağı işler:
- Repo içinde benzer feature’ları bul
- Pattern’leri çıkar (routing, auth, validation, DB access, test yaklaşımı)
- Edge case’leri gör (migration, backward compatibility)
- Yeni feature’ı ekle ve test et
Bu süreçte her dosya/klasör okuması ve her search bir tool çağrısı gibi düşünülür. Yani “tek shot” değil; n shot.
2) Operasyonel sistem agent’ı (ERP / CRM / ticketing)
İstenen: “1000 müşteriyi güncelle / 1000 kaydı import et.”
- Bulk API yoksa → her kayıt için ayrı tool çağrısı
- Her kayıtta farklı doğrulama → cross-check gerekir
- Hatalı kayıtlar için retry, exception handling
Burada 1000 tool çağrısı demek, context ve maliyet açısından çok zorlayıcıdır.
Context engineering: Çözüm alanı (birkaç seviye)
Aşağıda, sahada en sık kullanılan yaklaşımları “basitten karmaşığa” doğru anlatıyorum. Burada amaç tek bir “silver bullet” değil; bir strateji setioluşturmak.
Ön bilgi: “context” aslında üç farklı bütçedir
Pratikte “bağlam taşması” dediğimiz şey tek bir limit değildir; çoğu sistemde aşağıdaki üç bütçe birlikte çalışır:
- Input context budget: Modelin tek seferde okuyabildiği maksimum token.
- Output budget: Üretebileceği maksimum token (cevap / reasoning).
- Tool-return budget / serialization overhead: Tool çıktılarının (JSON, log, stacktrace, kod blokları) tokena dönüşürken yarattığı ek yük.
Bu yüzden tool-heavy bir akışta “asıl” büyüyen şey çoğu zaman kullanıcı konuşması değil; tool çıktılarının ham metni + tekrarlar + format overheadolur.
Token büyümesi nereden gelir? (teknik kırılım)
Bir zincirde token büyümesini anlamak için kabaca şu bileşenlere ayırmak faydalı:
- Sistem + talimat (genelde sabit)
- Plan / state (kontrollü büyümeli)
- Tool history (kontrolsüz büyümeye en yatkın)
- Ara kararlar (intermediate reasoning / scratchpad benzeri; bazı sistemlerde görünür, bazılarında gizli)
Tool history kısmında en sık “patlayan” içerikler:
- Büyük arama sonuçları (10–20 snippet yerine 2000 satır dump)
- Kod dosyalarının tamamı (gereksiz satırlar dahil)
- Stacktrace + log bundle’ları
Bu ayrımı netleştirmek önemli çünkü çözümün çoğu “daha iyi prompt” değil, hangi bileşenin büyümesini hangi politikayla sınırladığın ile ilgilidir.
Seviye 0: “Planlama” ile minimal disiplin
En basit yaklaşım:
- Agent her işi başta bir plana böler (ör. 5–8 adım)
- Her adımın çıktısını kısa bir “state update” olarak saklar
- Her adım bittikçe “bitti” diye işaretler
Neden işe yarar? Çünkü model, uzun tool history yerine kısa bir “şu an neredeyim?” özetini görür.
Örnek plan şablonu:
- Amaç
- Varsayımlar
- Kısıtlar (token limiti, tool rate limit, latency)
- Adımlar
- Çıkış kriteri (done definition)
Seviye 1: Otomatik özetleme (summarization) ile bağlamı stabilize etmek
Belirli bir eşikte (ör. toplam token veya tool çağrısı sayısı) şu yapılır:
- Son N adım ve kritik state hariç geçmiş “history” özetlenir
- Özet; deterministik bir formatta saklanır
- Yeni istekler özet + son adımlar üzerinden devam eder
“Özetleme”yi bir algoritma gibi düşünmek
Özetleme başarılı olsun istiyorsan, bunu “serbest yazı” değil state reductionolarak tasarlamak gerekir:
- Girdi:
(tool_calls[], tool_results[], current_plan, open_questions[]) - Çıktı:
(state_summary, retained_artifacts[], citations/refs[])
Burada kritik tasarım kararı: özetin yeniden üretilebilir olmasıdır. Yani bir sonraki adım “neden böyle yaptık?” diye sorduğunda cevap, özetin içinde bulunabilmeli.
Sliding window + summary: en stabil kombinasyon
Sahada en stabil desenlerden biri:
- Son K tool çağrısı ham haliyle tutulur (window)
- Daha eskisi özetlenir
- Özet “append-only” değil; versiyonlanır (v1, v2, v3) ve gerektiğinde yeniden sıkıştırılır
Bu, hem yakın geçmişteki ayrıntıyı kaybetmeden ilerlemeyi sağlar, hem de context’i deterministik bir sınırda tutar.
Özetin mutlaka taşıması gerekenler:
- Şu ana kadar ne yapıldı?
- Hangi kararlar verildi (ve neden)?
- Hangi tool’lar çağrıldı, hangi sonuçlar önemli?
- Yarım kalan adım ne?
- Bundan sonra sıradaki 1–2 adım ne?
Burada kritik nokta: Özet “edebi” değil, operasyonel olmalı.
Mini örnek: Özet formatı
STATE SUMMARY (v3)
Goal: X’i tamamla.
What we tried:
- Search query A → sonuçlar yetersiz.
- Search query B → 2 relevant doc bulundu: Doc1, Doc2.
Decisions:
- Doc2 pattern’i kullanılacak (sebep: auth guard uyumlu).
Open tasks:
- Edge-case: rate limit handling belirsiz.
Next step:
- Tool: repo.readFile(path=...) ile rate-limit middleware’i incele.
Seviye 2: Tool history’i “ayrı yere” taşımak (external memory / caching)
Tekrar eden tool çağrılarını azaltmak için:
- Tool response’ları cache’lenir (RAM / KV store / DB)
- Aynı parametrelerle aynı tool çağrısı gelirse model tekrar çağırmak yerine cache’den okur
- Cache key genellikle:
(tool_name, normalized_args, version)gibi olur
Örnek: Repo taramasında aynı dosyayı 3 kere okumak yerine tek kez oku.
Bu yaklaşım yalnızca token/maliyet azaltmakla kalmaz; aynı zamanda context’e “gereksiz tekrar” girişini de engeller.
Cache tasarımında teknik nüanslar
Cache key’i pratikte şu alanları da içermelidir (yoksa yanlış hit alırsın):
- Tenant/workspace id
- Auth scope / user id (aynı tool farklı yetkilerle farklı sonuç dönebilir)
- Tool implementation version (değiştiyse eski sonuç geçersiz)
- Source version (ör. repo commit SHA, DB snapshot timestamp)
Ek olarak:
- Idempotency: Özellikle write tool’larında (create/update) aynı isteğin tekrar çalışması zararlı olabilir. Bu yüzden her “write” çağrısı için
idempotency_keybenzeri bir mekanizma (veya işin doğasına uygun deterministic key) çok kritik hale gelir. - Negative caching: “Bulunamadı” sonuçlarını kısa süreli cache’lemek, tool spam’ini ciddi azaltır (ama TTL kısa olmalı).
Seviye 3: Seçici bağlam (selective context) ve “kritik bilgi extraction”
Bazen özet yetmez; çünkü bazı bilgiler:
- Tablo gibi yapılandırılmıştır
- Kod snippet’leri gibi “tam kopya” ister
- Hata mesajı gibi birebir gereklidir
Bu durumda:
- Tool çıktısından kritik parçaları çıkar (ör. sadece fonksiyon signature, sadece error stack’in top 15 satırı)
- Geri kalanı external memory’de tut
- Modelin context’ine sadece “need-to-know” koy
Pratik heuristic:
- “Decision-making” için gereken minimum
- “Implementation” için gereken tam parça
- Geri kalan → dış bellek / link / referans
Seçici bağlamı formalize etmek: Artifact modeli
Bu yaklaşım daha teknik bir “artifact” modeliyle çok daha sağlam hale gelir:
- Artifact: Tool çıktısından çıkarılmış, kimliklendirilmiş ve referanslanabilir parça.
- Alanlar:
id,type(snippet/table/error/log),source(tool+args),checksum,created_at,retention_policy.
Modelin context’ine:
- artifact’in kendisi değil, çoğu zaman özet + artifact id + nerede durduğugirer.
- “Tam parça” gerekiyorsa sadece o artifact’in içeriği enjekte edilir.
Bu, context’i “rastgele büyüyen log” olmaktan çıkarıp, adreslenebilir bilgi deposu haline getirir.
Test & gözlemleme: Bu yapıyı nasıl güvenilir hale getirirsin?
Tool-heavy agent’larda kaliteyi kontrol etmek için iki şey kritik:
- Çıktı kalitesi (final answer doğru mu?)
- Araç davranışı (doğru tool’lar doğru sırada çağrılıyor mu?)
Sahada yaygın yaklaşım:
- Ayrı bir “evaluation / judge” seti hazırlanır (golden test cases)
- Senaryoda beklenen tool çağrıları tanımlanır (ör. “en az 1 kez search”, “en az 1 kez DB query”, “şu tool asla çağrılmamalı”)
- Gözlemleme ile:
- Tool call sayısı
- Tool latency
- Cache hit ratio
- Token büyüme eğrisi
- Summarization tetiklenme sıklığı
- “Repeat call” oranı izlenir
Teknik observability: hangi sinyaller gerçekten işe yarar?
Tool-heavy agent’larda “neden başarısız oldu?” sorusunu cevaplamak için metrik + trace birlikte gerekir:
- Trace: Her tool çağrısı için
tool_name, args hash’i, latency, status, result_size (byte/token), retry count. - Context telemetry: Her adımda “context token sayısı” ve en büyük contributor (ör. top-3 tool result).
- Decision log: Özetleme tetiklendiyse “neden tetiklendi?” (threshold, heuristic) ve “ne retain edildi?”.
Bu sinyaller olmadan çoğu optimizasyon kör uçuş olur: “prompt’u değiştirdik, iyileşti mi?” gibi ölçümsüz iterasyonlara dönersin.
Basit bir metrik örneği
- Ortalama tool çağrısı / görev
- Tekrarlanan tool çağrısı yüzdesi
- Ortalama “context refresh” (özetleme) sayısı / görev
- İlk doğru cevap oranı (first-pass success)
Ne zaman hangi yaklaşım?
- Az tool, kısa çıktı → Planlama çoğu zaman yeter.
- Iteratif arama → Summarization + selective context.
- Repo / büyük doküman → External memory + caching + selective extraction.
- Yüksek hacimli operasyon (1000+ işlem) → External memory + batching (varsa) + idempotency + retry stratejisi.
Son söz: Context engineering bir “prompt işi” değil, sistem tasarımıdır
“Context engineering”i sadece prompt’a sıkıştırmak genellikle yetmez. Tool-heavy agent’larda bağlam yönetimi:
- state tasarımı,
- cache stratejisi,
- özetleme politikası,
- observability,
- evaluation setleri
gibi birden fazla katmanda ele alınmalı.
Eğer tek bir cümleyle özetleyeceksem:
Tool-heavy agent’larda başarı, modelin zeki olmasından çok, bağlamın doğru yönetilmesine bağlıdır.