Loop Engineering: Agent’ı “Çalıştırmak” Değil, Döngüyü Yönetmek

Son birkaç yılda “agent” kelimesi o kadar geniş kullanıldı ki çoğu zaman tek bir LLM çağrısı + birkaç tool bile “agent” diye etiketleniyor. Oysa üretimde gerçek problem prompttan çok daha büyük: agent’ın döngüsü (loop) nasıl çalışıyor?Ne zaman tekrar deniyor, ne zaman duruyor, nasıl ölçülüyor, nasıl güvenli kalıyor?
Bu yazıda “Loop Engineering”i — yani agent loop’unu tasarlama ve işletme disiplinini — hem pratik hem teorik bir çerçeveyle ele alacağım.
Prompt Engineering mi, Loop Engineering mi?
Prompt engineering tek bir çağrının içeriğini optimize eder: “Bu modele ne söylemeliyim ki daha iyi cevap versin?”
Loop engineering ise bir run boyunca oluşan zinciri tasarlar: “Model ne zaman tool’a gitsin, ne zaman tekrar denesin, ne zaman durup insana sorsun, nasıl ölçülsün?”
Özet:
- Prompt = tek adım
- Loop = çok adımlı sistem
İkisi birbirinin rakibi değil; tamamlayıcısı. Ama üretimde çoğu sorun prompt kaynaklı değil, loop kaynaklı.
Loop’u Bir Control System Olarak Düşünmek
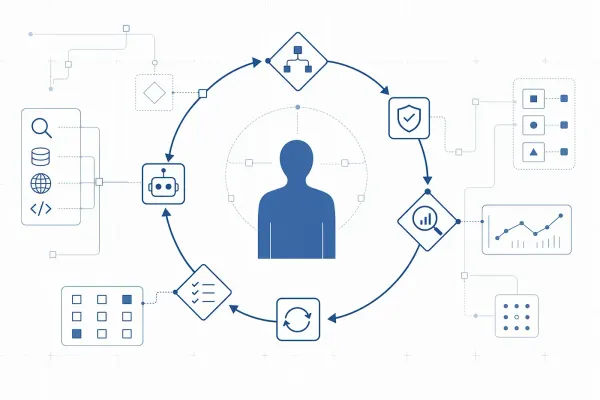
Agent loop’unu anlamanın en temiz yolu, onu bir geri beslemeli kontrol sistemi olarak modellemek:
- Loop / runtime: durumun evrildiği ortam — state, tool çıktıları, kullanıcı girdileri
- LLM: her adımda “ne yapmalı?” kararını üreten kontrolcü
- Tool’lar: sisteme etki eden aktüatörler — yazma, okuma, işlem
Bu analoji birebir değil ama iki şeyi net açıklıyor:
- Geri besleme yoksa sistem kararsızlaşır.
- Budget yoksa sistem “enerjiyi” sınırsız harcar.
Bir Agent Loop’un Anatomisi
Bir agent run’ı genelde şu bileşenlerin birleşimidir:
State (durum): Konuşma, ara çıktılar, tool sonuçları, sayaçlar (retry/budget)
Policy (politika): “Şu durumda tool kullan / şu durumda dur / şu durumda eskale et”
Planner/Router: Görevi parçalara ayırma, “sonraki adım ne?”
Executor: Tool çağırma + çıktıyı birleştirme
Verifier/Critic (opsiyonel ama çok değerli): Çıktı doğru mu, format doğru mu, eksik var mı?
Bu parçaları ayrı ayrı düşünmek kritik; çünkü loop engineering çoğu zaman “modeli değiştirmek” değil, policy ve state’i düzeltmektir.
Loop’ların En Sık Patladığı Yer: Başarısızlık Modları
Agent’lar üretimde genelde şu şekillerde bozulur:
1. Infinite / degenerate loop: Aynı adımları döndürür, ilerleme yoktur.
2. Tool thrashing: Sürekli tool’a gider gelir; maliyet artar, hız düşer.
3. Context ballooning: Her iterasyonda bağlam şişer; kalite düşer, maliyet artar.
4. Silent failure: Tool hatası veya eksik deliverable olmasına rağmen “tamam” diye döner.
5. Spec drift: İlk amaçtan sapar; “başka bir problemi çözer.”
Loop engineering’in “gerçek işi” bu modlara karşı guardrail koymaktır.
Neden Infinite Loop Olur? Stability Problemi
Control system perspektifinden bakınca infinite loop’un nedenleri netleşir:
- “İlerleme”yi ölçen bir sinyal yoktur (progress metric yok)
- Stop condition belirsizdir (“tamam mı?” tanımı yok)
- Tool hata/eksik çıktıları normalleştirilmiştir (silent failure)
- Context şişmesi nedeniyle model karar kalitesi düşer, tekrarlar artar
Çözüm: İlerleme metriği + stop condition + guardrail.
Feedback Kaynakları: Agent Neye Bakarak Karar Veriyor?
Loop’u stabilize eden geri besleme sinyalleri:
- Tool çıktıları (structured)
- Verifier/Critic skoru (format / doğruluk / eksik)
- Kullanıcı düzeltmesi (human feedback)
- Observability metrikleri (time/token/tool budget)
Feedback zayıfsa agent “kendini tekrar eden” davranışlara kayar. Bu da loop engineering’in aslında büyük ölçüde feedback kanallarını tasarlamakolduğu anlamına gelir.
Guardrail’ler: Döngüyü Stabil Tutan Basit Kurallar
Üretimde iş gören temel korumalar:
maxIterations → ör. 5–8 adım sonra "dur ve özetle"
time/token budget → bu run en fazla X saniye / Y token / Z tool call
stop conditions → çıktı şu formatı sağladıysa bitir
fallback policy → olmazsa insana sor / partial output ver
idempotency → aynı tool'u tekrar çağırınca yan etkisi var mı?
Bu kurallar yoksa en iyi prompt bile zamanla “runtime’da kaynar.”
Gerçek Dünya Senaryosu: Codebase Agent’ı
Teorik çerçeveyi somutlaştırmak için tipik bir örneğe bakalım.
Görev: “Authentication middleware’e rate limiting ekle.”
Kulağa basit geliyor. Ama agent’ın pratikte yapacağı şu:
[1] search_codebase("rate limit middleware") → 3 dosya bulundu
[2] read_file("src/middleware/auth.ts") → 180 satır okundu
[3] read_file("src/middleware/index.ts") → bağımlılık haritası
[4] search_codebase("existing rate limit utils") → sonuç yok
[5] read_file("package.json") → mevcut kütüphaneler
[6] write_file("src/middleware/rateLimiter.ts") → yeni dosya oluşturuldu
[7] edit_file("src/middleware/auth.ts") → middleware zinciri güncellendi
[8] run_tests("src/middleware/") → 2 test başarısız
[9] read_file("src/middleware/auth.test.ts") → test mantığı incelendi
[10] edit_file("src/middleware/auth.ts") → edge case düzeltildi
[11] run_tests("src/middleware/") → tüm testler geçti
11 adım, 4 farklı tool tipi, 2 retry döngüsü. Bu henüz “basit” bir senaryo.
Guardrail’siz ne olur?
Adım 4'te search_codebase boş döndüğünde agent ne yapar? İyi bir policy yoksa iki olasılık var: ya aynı sorguyu farklı parametrelerle tekrar tekrar dener (tool thrashing), ya da hiç rate limiting utility'si olmadığını anlamadan bir yerden kopyalar (spec drift).
Loop engineering devrede olduğunda:
- Adım 4
incompletedöner: "Rate limit utility bulunamadı, sıfırdan yazılacak — onaylıyor musun?" - Adım 8'de test başarısız olunca retry budget devreye girer: en fazla 2 deneme hakkı
- Adım 11'de tüm testler geçince stop condition tetiklenir; agent durur ve özet üretir
- Her adım loglanır: tool adı, süre, sonuç boyutu, karar gerekçesi
Context ballooning riski: 11 adımda biriken tool çıktıları (dosya içerikleri, test logları, search sonuçları) hızla şişer. Checkpoint özetlemesi olmadan adım 9–10'da agent, adım 1–3'teki kararları artık “göremeyebilir” — ve aynı dosyaları yeniden okumaya başlar.
Bu senaryo başarısızlık modlarının tamamını bir arada barındırıyor: potential infinite loop (adım 4), tool thrashing (arama retry’ları), context ballooning (biriken dosya içerikleri), silent failure riski (test hatasını görmezden gelme), spec drift (yanlış utility kopyalama). Loop engineering, bu domino etkisini başlamadan kesen katmandır.
Budget = Enerji Limiti
Üretimde loop engineering’in en net kazanımı: maliyet kontrolü.
Önerilen budget katmanları:
- Token budget — toplam token tüketimi
- Time budget — maksimum çalışma süresi
- Tool budget — kaç tool çağrısına izin var
- Retry budget — aynı adım kaç kere tekrar denenebilir
Bunlar sadece “kısıt” değil, aynı zamanda karar sinyali: “Ucuz yol yetmezse eskale et.”
Context Engineering: Loop’un Gizli Katmanı
Damping bölümünde context ballooning’den söz ettik. Ama bu problem tek başına ele alınmayı hak ediyor — çünkü tool-heavy agent’larda çoğu loop çöküşünün kökü buradadır.
Context engineering, agent’ın her adımda “ne bilmesi gerektiğini” aktif olarak yönetme disiplinidir. Prompt engineering ne yazılacağını optimize ederken, context engineering neyin tutulacağını, neyin atılacağını, neyin özetleneceğini belirler.
Pratikte “context” üç ayrı bütçedir:
- Input context budget — modelin tek seferde okuyabildiği maksimum token
- Output budget — üretebileceği maksimum token
- Tool-return overhead — tool çıktılarının (JSON, log, dosya içeriği) token karşılığı
Tool-heavy bir loop’ta asıl büyüyen şey kullanıcı konuşması değil, tool history’nin ham metnidir. Codebase agent senaryomuzda 11 adım boyunca biriken dosya içerikleri, test logları ve search sonuçları bunu net gösteriyor.
Seviye 0 — Planlama ile Minimal Disiplin
En basit yaklaşım: agent her şeyi ham tutmak yerine baştan bir plan üretir ve her adımda yalnızca “neredeyim?” özetini taşır.
FUNCTION run_agent(goal):
plan = {
goal: goal,
assumptions: [],
constraints: { max_steps: 8, max_tokens: 50000 },
steps: decompose(goal), // 5-8 alt adım
done_when: "all tests pass AND no lint errors"
}
state = { plan: plan, completed: [], current_step: 0 } WHILE state.current_step < plan.steps.length:
step = plan.steps[state.current_step]
result = execute(step)
// Ham çıktıyı context'e koymak yerine kısa özet sakla
state.completed.append({
step: step.id,
status: result.status, // success | failure | incomplete
summary: result.summary, // 1-2 cümle, karar gerekçesi
artifacts: result.artifact_ids
})
IF is_done(state, plan.done_when):
RETURN { status: "success", state: state }
state.current_step += 1 RETURN { status: "incomplete", next: suggest_next(state) }
Neden işe yarar? Model, 11 adımın ham tool çıktısı yerine her adımın kısa özetini görür. Karar kalitesi düşmez, context şişmez.
Seviye 1 — Otomatik Özetleme ile Bağlamı Stabilize Etmek
Belirli bir eşiğe ulaşınca geçmiş history özetlenir, yalnızca son K adım ham haliyle tutulur.
FUNCTION manage_context(history, config):
total_tokens = estimate_tokens(history)
IF total_tokens > config.summarize_threshold: // ör. 30.000 token
// Son K adımı koru, geri kalanı özetle
recent = history.last(config.window_size) // ör. son 3 adım
older = history.slice(0, -config.window_size)
summary = summarize(older, schema = {
what_was_done: "string", // tamamlanan adımlar
key_decisions: ["string"], // neden bu kararlar?
important_tools: ["string"], // hangi tool'lar kritik sonuç döndürdü?
open_questions: ["string"], // hâlâ belirsiz olan ne?
next_1_2_steps: ["string"] // plan değiştiyse yeni sıra
})
// Özet versiyonlanır — gerektiğinde yeniden sıkıştırılabilir
compressed_history = [
{ type: "summary", version: history.summary_count + 1, content: summary },
...recent
]
RETURN compressed_history
RETURN history // eşik aşılmadıysa dokunma
Kritik tasarım kararı: Özet “edebi” değil, operasyonel olmalı. “Çok şey yapıldı” değil; “adım 3'te auth.ts okundu, rate limiter utility olmadığı görüldü, sıfırdan yazılmasına karar verildi” — bir sonraki adım bu kararı neden böyle aldığımızıözetin içinde bulabilmeli.
Seviye 2 — Tool Çıktılarını Normalize Etmek
Tool’dan gelen ham veriyi doğrudan context’e koymak yerine, modelin karar için ihtiyaç duyduğu minimum’u ayıklarsın.
FUNCTION normalize_tool_output(tool_name, raw_output): IF tool_name == "read_file":
// 180 satırlık dosyayı ham koymak yerine:
RETURN {
file: raw_output.path,
size_lines: raw_output.line_count,
imports: extract_imports(raw_output.content),
exports: extract_exports(raw_output.content),
key_sections: extract_relevant_sections(
raw_output.content,
keywords = ["middleware", "auth", "rate"]
),
artifact_id: store_full(raw_output) // tam içerik dışarıda saklanır
} IF tool_name == "run_tests":
// Tüm test output'u yerine sadece sonuç özeti:
RETURN {
passed: raw_output.passed_count,
failed: raw_output.failed_count,
failures: raw_output.failures.map(f => ({
test: f.name,
reason: f.error_message.first_line() // stacktrace değil, mesaj
})),
artifact_id: store_full(raw_output)
} IF tool_name == "search_codebase":
RETURN {
query: raw_output.query,
hit_count: raw_output.total_hits,
top_files: raw_output.results.slice(0, 3).map(r => r.file_path),
artifact_id: store_full(raw_output)
} // Default: ham çıktıyı dışarıda sakla, context'e sadece özet koy
RETURN {
tool: tool_name,
status: raw_output.status,
summary: raw_output.summary ?? truncate(raw_output, 200),
artifact_id: store_full(raw_output)
}
Artifact pattern: Her tool çıktısı dışarıda (RAM/KV store) saklanır ve bir artifact_id ile referanslanır. Model context'inde sadece özet + id bulunur. "Tam parça" gerektiğinde — örneğin adım 9'da test hatasını incelemek için — yalnızca o artifact enjekte edilir.
Üç Seviyeyi Codebase Senaryosuna Uygulamak
Senaryomuzda 11 adım boyunca ne birikir?
// Seviye 0 olmadan (ham context):
context_tokens = [
system_prompt(800),
file_auth_ts(2200), // 180 satır
file_index_ts(900),
file_package_json(400),
file_rateLimiter_ts(1100), // yeni yazılan dosya
test_output_failed(600), // 2 başarısız test logu
file_auth_test_ts(1400),
test_output_passed(400)
] // TOPLAM ≈ 7.800 token — bu "iyi" senaryo; gerçekte çok daha fazla// Seviye 0 + 1 + 2 ile (normalize + özetleme):
context_tokens = [
system_prompt(800),
state_summary_v1(350), // adım 1-3 özeti
normalized_auth_ts(280), // sadece import/export + ilgili bölümler
normalized_test_fail(120), // sadece hata mesajları
normalized_test_pass(80) // sadece "11/11 passed"
] // TOPLAM ≈ 1.630 token — %79 azalma, karar kalitesi korunuyor
Context engineering burada sadece maliyet meselesi değil. 7.800 token’lık bir history’de model adım 1'deki kararları “göremeyebilir” veya düşük ağırlıklandırabilir — bu da spec drift’e zemin hazırlar. 1.630 token’lık sıkıştırılmış context’te her karar görünür ve erişilebilirdir.
Pattern: “Incomplete” Birinci Sınıf Sonuç Olmalı
Üretimde en büyük farkı yaratan tasarım kararı:
Başarısızlık ile “tamamlanmadı”yı ayır.
failure→ yanlış, bozuk, güvenilmezincomplete→ doğru yönde ama eksik; "bir sonraki adım" net
Bu yaklaşım loop’un “güzelce durmasını” sağlar:
- Kullanıcıdan onay ister (human-in-the-loop)
- Eksik capability talep eder
- “Şu 2 bilgi gelirse tamamlarım” diye netleşir
incomplete'i birinci sınıf vatandaş yapmak; onay, eksik bilgi ve capability escalation akışlarını düzenler.
Observability: Ölçmediğin Loop’u İyileştiremezsin
Loop engineering’i “engineering” yapan kısım ölçümdür. Minimum metrikler:
- İterasyon sayısı (run başına)
- Tool çağrısı sayısı + latency + error rate
- Token/maliyet (run başına)
- First-pass success rate
- Retry sonrası başarı oranı
- Kaç kere “insana sordu” / “onay bekledi”
Basit kural: Her step, loggable bir event olmalı — girdi/çıktı özetleri + karar gerekçesi (kısa).
Sonuç: Agent Değil, Loop Ürünleştirilir
Agent’ı “akıllı” yapan model olabilir; ama agent’ı üretimde yaşatan şey döngünün stabilitesidir:
- State + policy + guardrail
incomplete/ approval gibi semantik duruşlar- Observability ve eval
Loop engineering, agent’ı koşan değil, agent’ı yöneten katmandır.
Loop Engineering Checklist
Loop katmanı
☐ maxIterations / budget tanımlı
☐ Stop condition'lar net
☐ Retry politikan var (neye, kaç kere?)
☐ Tool hatalarında silent failure yok
☐ "incomplete" akışı var (next step öneriyor)
☐ Riskli tool'lar onay gerektiriyor
☐ Her step için event log var
☐ Run başı maliyet/latency ölçülüyor
☐ En az 1 eval senaryosu mevcut (happy + failure path)
Context engineering katmanı
☐ Tool çıktıları normalize ediliyor (ham değil, özet + artifact_id)
☐ Özetleme eşiği tanımlı (token veya adım sayısı bazlı)
☐ Özet şeması operasyonel: karar gerekçeleri kayıt altında
☐ Artifact'lar dışarıda saklanıyor, gerektiğinde enjekte ediliyor
☐ Context token büyümesi her run'da ölçülüyor
☐ Sliding window boyutu test edildi (son K adım yeterli mi?)
Bir sonraki yazıda tool-heavy agent’larda external memory, caching stratejileri ve artifact modelini daha derinlemesine inceleyeceğim.